Nos últimos meses, os agentes de IA que rodamos na Complyance passaram a escrever e executar código contra os sistemas dos próprios clientes: organizações no GitHub, contas AWS, provedores de identidade e repositórios de documentos. Eles fazem isso a partir de um sandbox que tem acesso à internet. Nada dentro desse sandbox consegue se autenticar em nenhum desses sistemas.
Levamos um tempo para acertar essa combinação, e acho que o padrão por trás dela vai importar para qualquer pessoa que deixa agentes agirem sobre infraestrutura real. A ideia central cabe em uma frase: o agente recebe uma capability, não uma credencial. Este post explica o que isso significa na prática, os designs que deixamos de lado no caminho e onde ficam os seus limites, que é a parte que eu leria primeiro se estivesse avaliando o design de outra pessoa.
Por que nossos agentes escrevem código
Nossos agentes coletam evidências de compliance. Um pedido como “mostre que a proteção de branch está ativa em todos os repositórios de produção” parece simples. Na prática, significa percorrer centenas de repositórios através de uma API com milhares de endpoints. Uma conta AWS pode devolver 1.247 hosts para uma única pergunta de inventário.
Tools tipadas, uma função por operação, sofrem nessa escala. Nenhum modelo consegue manter mil descrições de tools em mente, e todo resultado intermediário precisa passar pela janela de contexto. Por isso migramos para o que hoje se chama de code mode. O agente recebe um sandbox, uma referência curta para cada sistema conectado e uma pequena biblioteca cliente, e escreve um script que faz o loop e a filtragem sozinho. Só o resumo volta para o contexto. Os modelos são muito melhores escrevendo vinte linhas de Python contra uma API do que orquestrando duzentas chamadas de tools.
O problema de deixar uma chave na sala
Simon Willison descreve uma “tríade letal” para agentes: acesso a dados privados, exposição a conteúdo não confiável e um jeito de mandar dados para fora. Um agente em code mode tem as três por design. Ele passa o dia lendo texto escrito por outras pessoas, executa código, e o sandbox dele acessa a internet porque trabalho útil muitas vezes precisa disso.
Coloque uma credencial nesse ambiente e um único prompt injection, escondido na descrição de um pull request que o agente por acaso leia, pode gerar um script que imprime o token e manda para algum lugar. Treinamento e prompts melhores deixam isso menos provável. Não deixam impossível, porque o modelo é justamente o componente com quem o atacante está conversando. A resposta robusta é estrutural: garantir que não exista nada no sandbox que valha a pena roubar.
Três designs que deixamos de lado
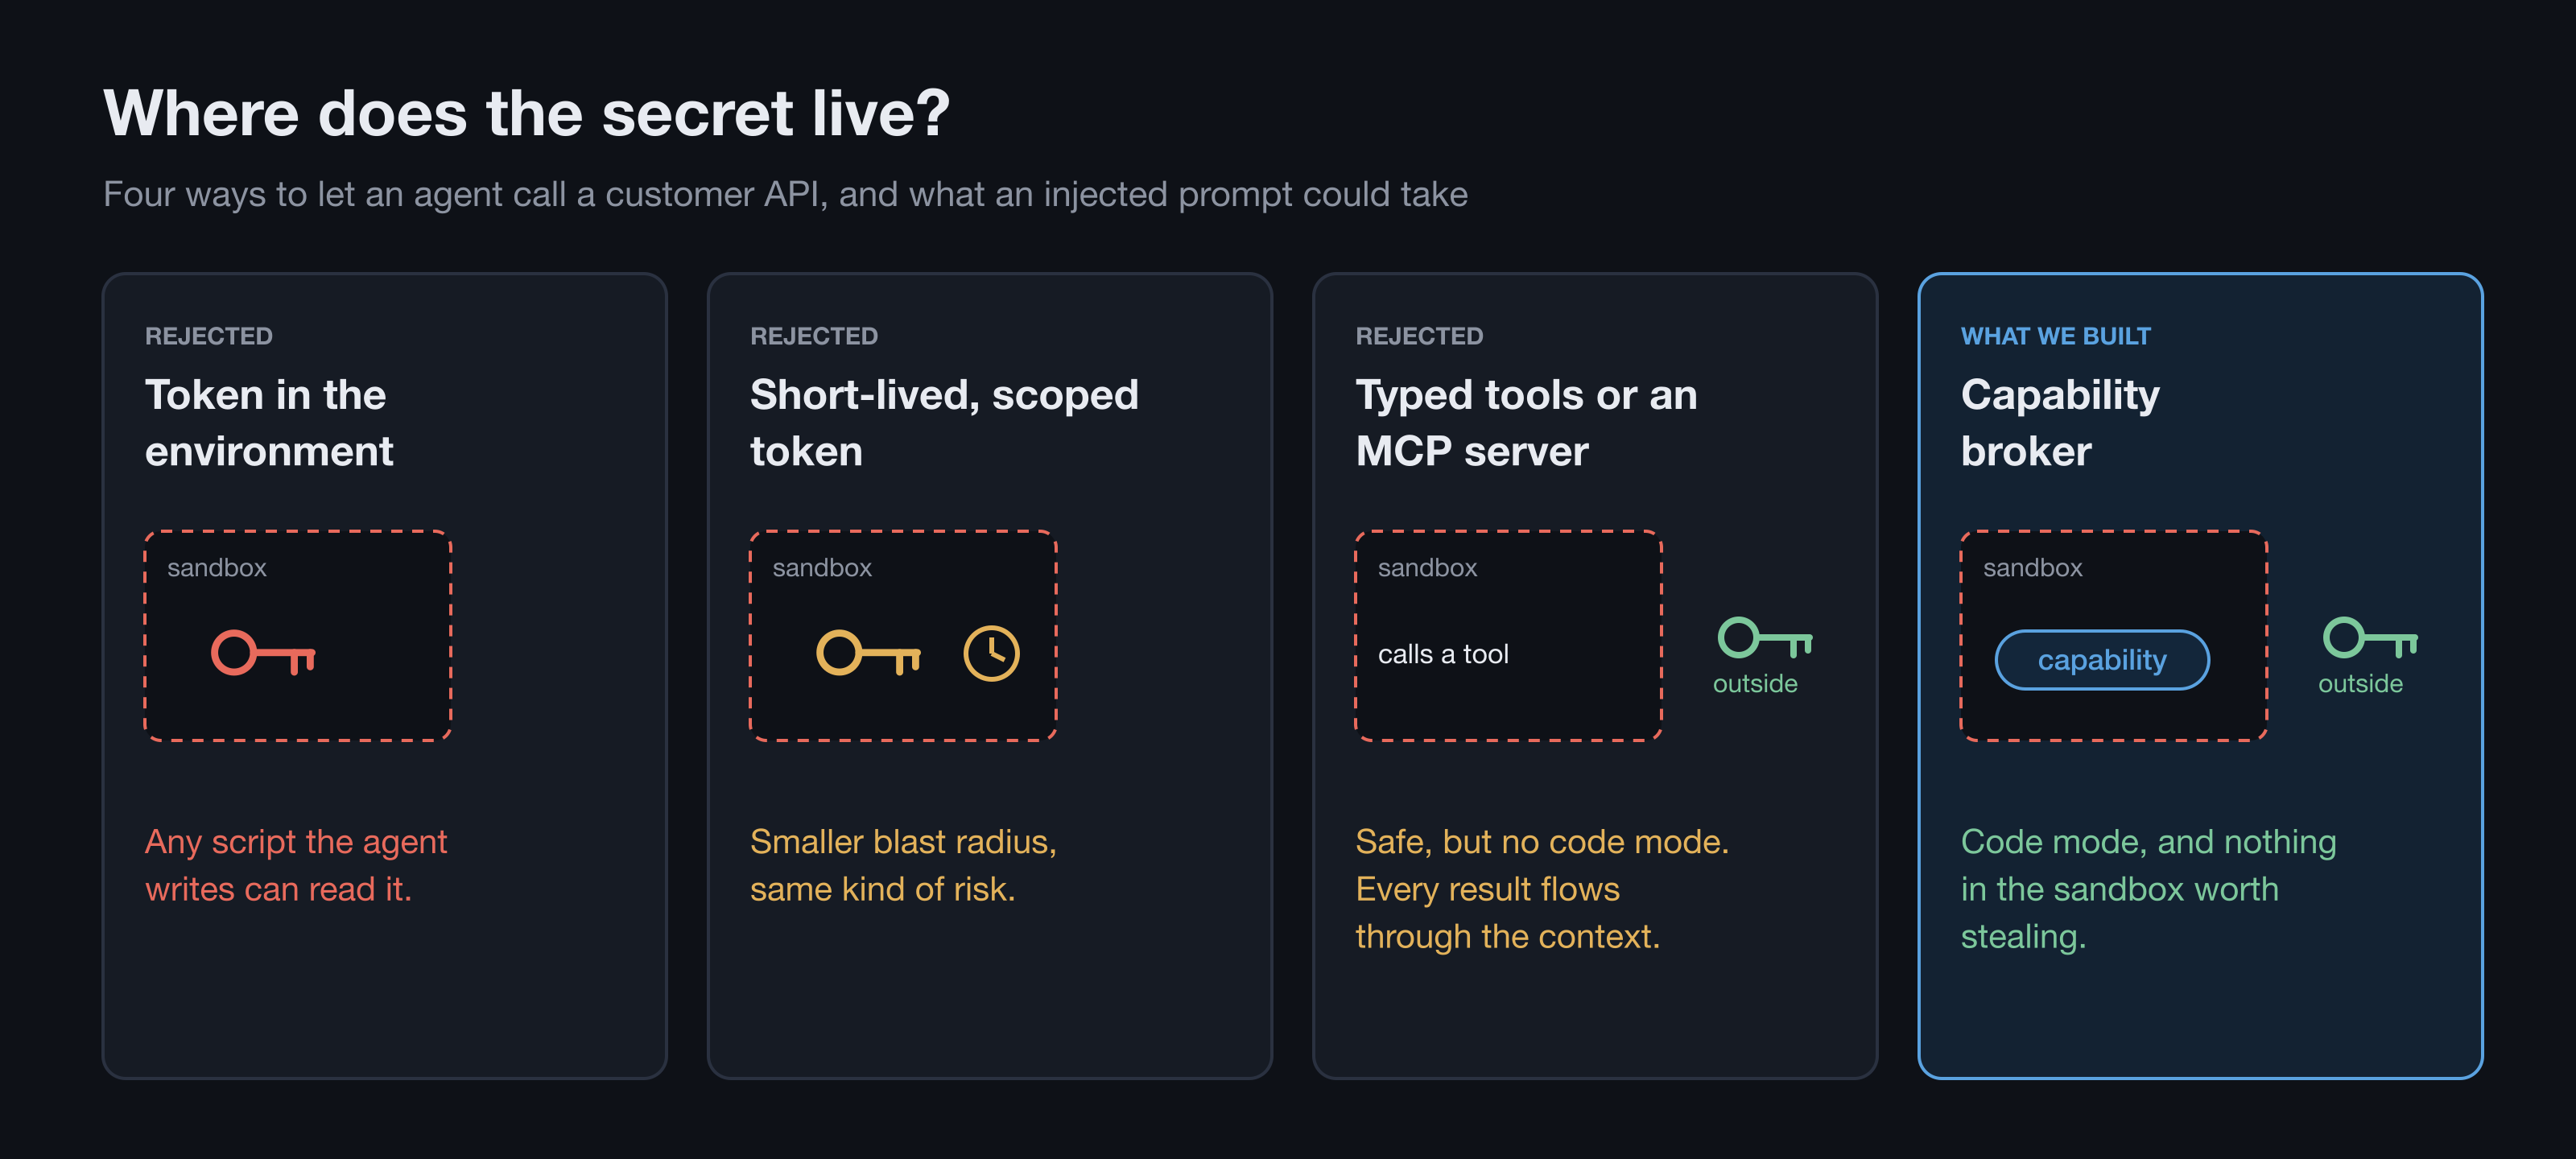
A primeira versão do nosso protótipo guardava um token no processo da tool e o anexava a cada chamada. Funcionava, e é exatamente o cenário que a tríade explora. Tudo o que o sandbox consegue ler, um script injetado também consegue.
A versão mais cuidadosa entrega ao sandbox um token de curta duração, com escopo limitado ao que o run precisa. Isso reduz o raio de impacto, mas nossas próprias notas de design deixam a limitação clara: o token continua “legível e utilizável durante toda a sua vida útil”. Quinze minutos é tempo de sobra para um código que já está rodando, e privilégio mínimo para um agente de evidências ainda significa acesso de leitura à organização inteira do cliente no GitHub.
Tools tipadas, ou um servidor MCP que guarda os segredos, de fato mantêm as credenciais fora do sandbox. Mas também eliminam o code mode, e toda resposta volta passando pelo modelo. Queríamos as duas coisas ao mesmo tempo: a expressividade do código, com as credenciais tratadas inteiramente fora do sandbox.
Capability, não credencial
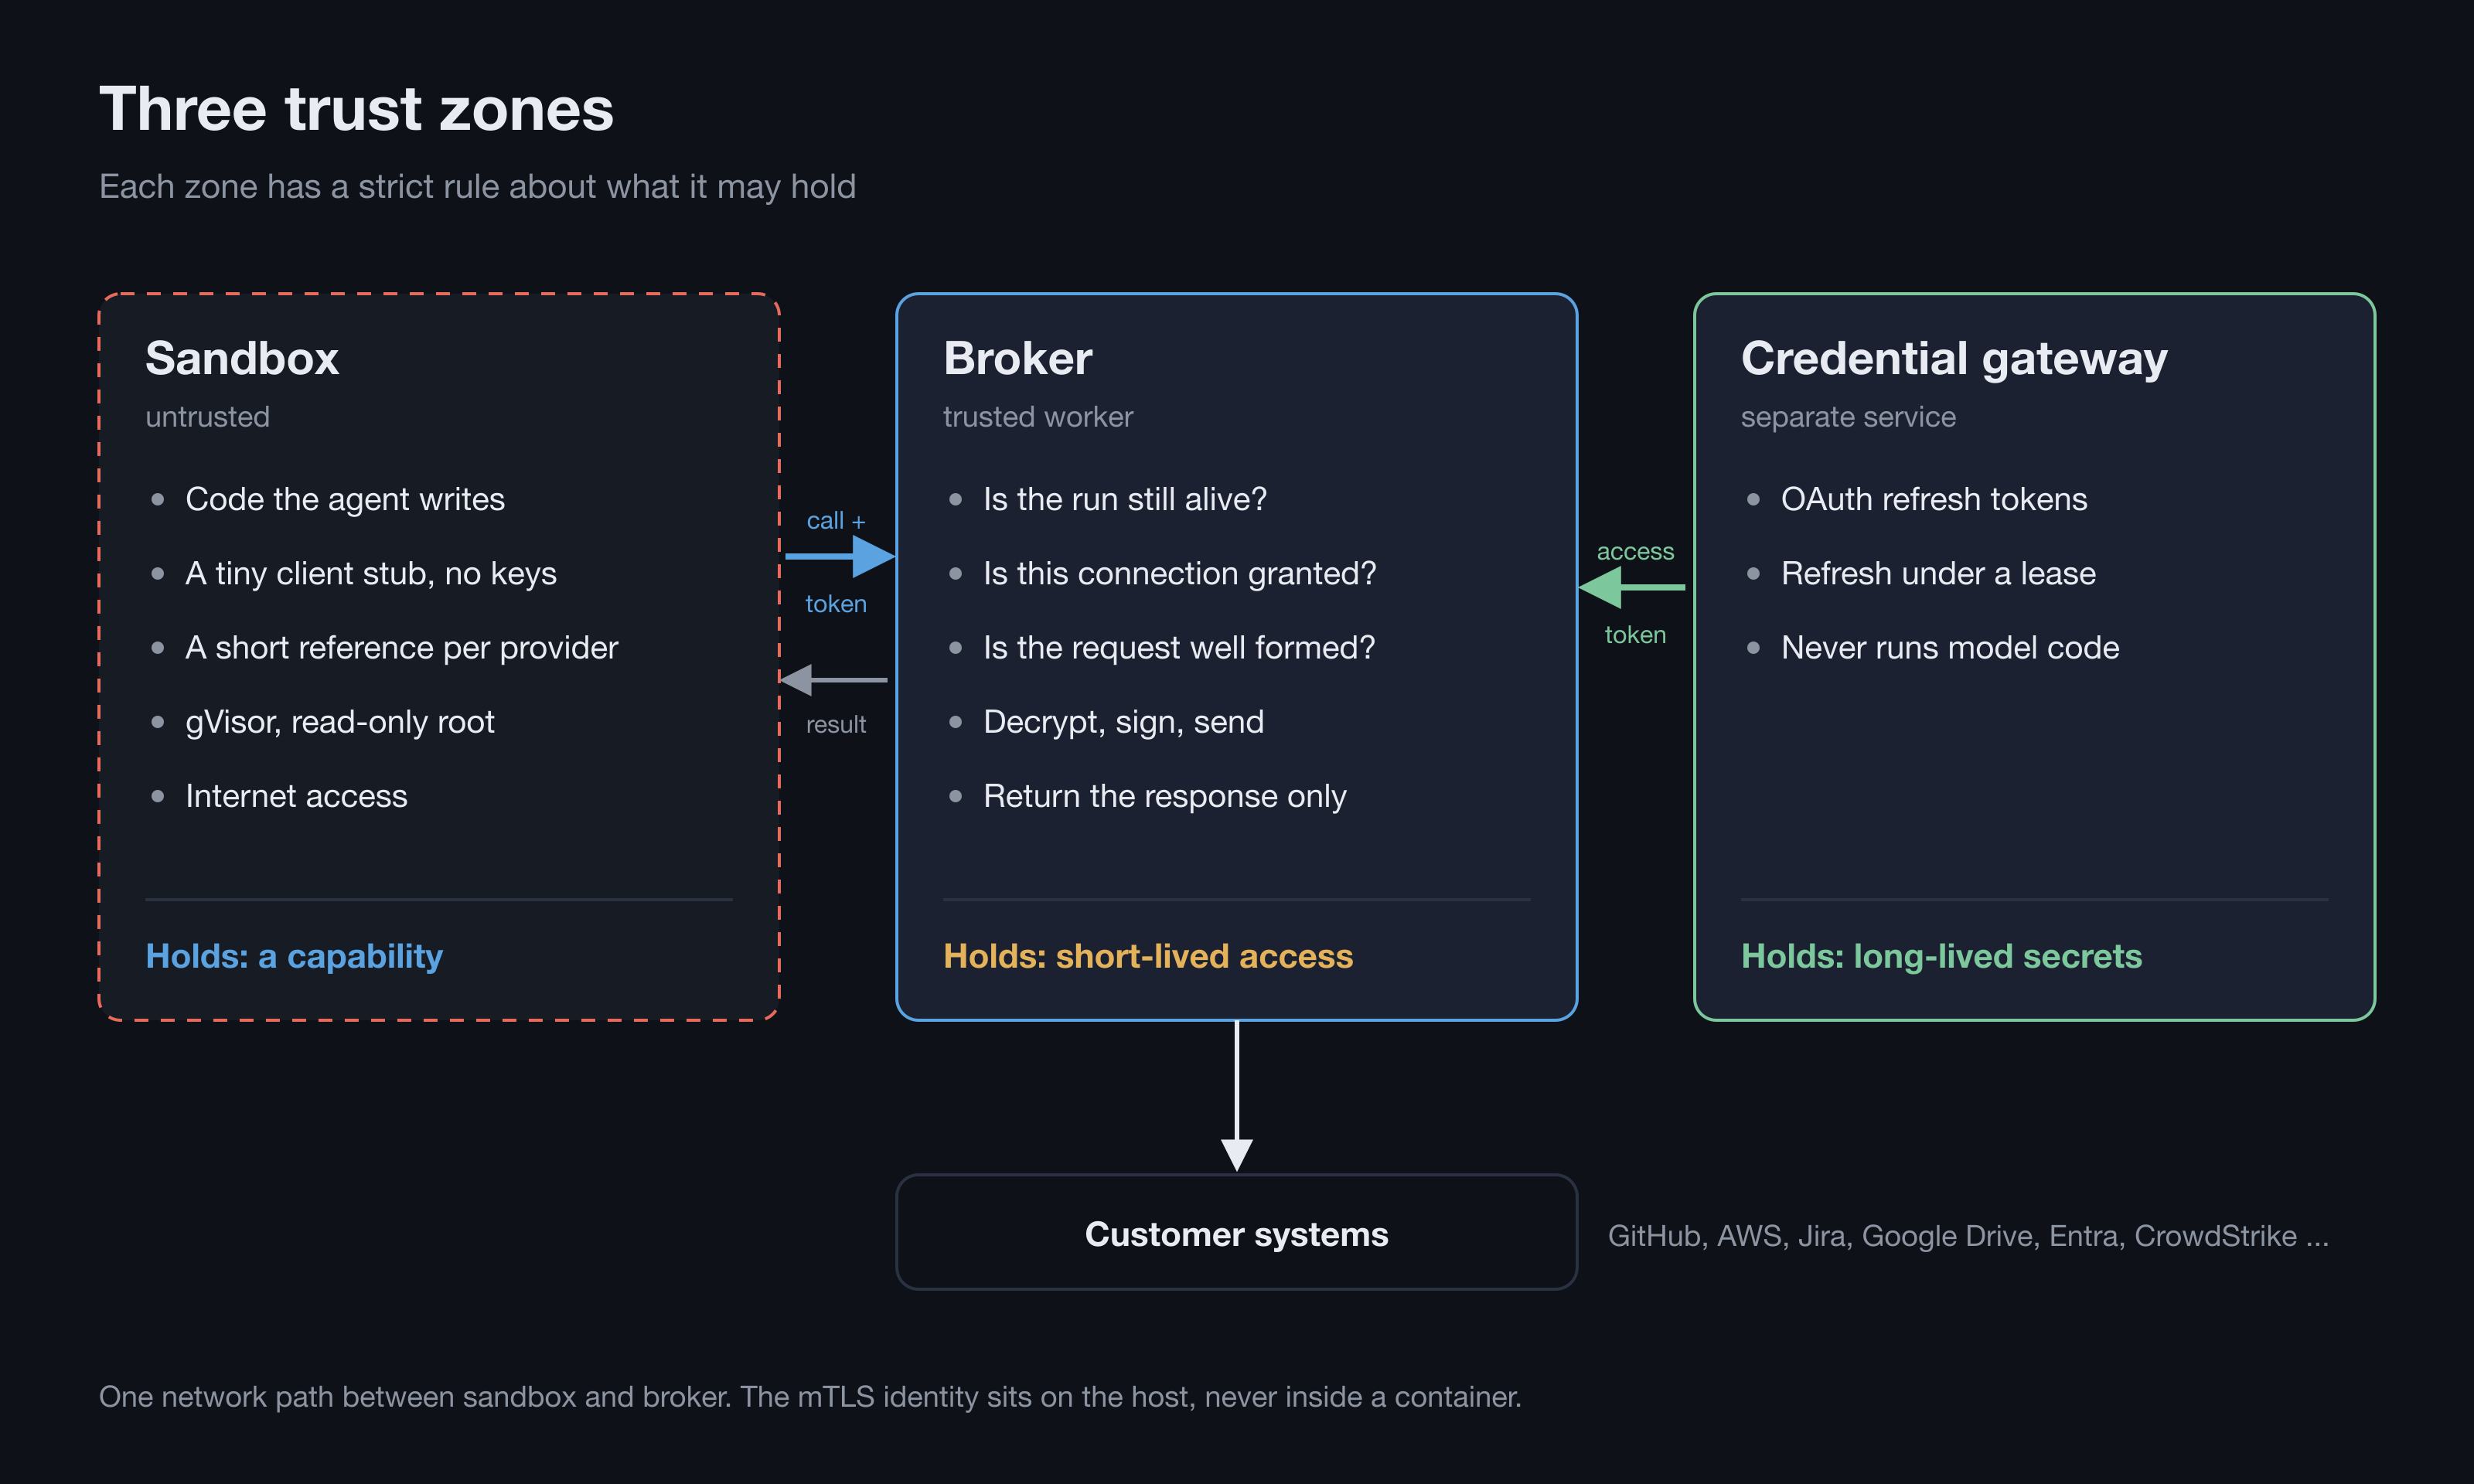
O design divide o trabalho em três zonas, cada uma com uma regra rígida sobre o que pode guardar.
O sandbox é não confiável por definição. É um container com gVisor, sistema de arquivos raiz somente leitura e acesso à internet. Quando um run começa, ele recebe um stub cliente de umas cem linhas, um token de capability para aquele run e uma referência curta para cada sistema que o cliente conectou. Chamar o GitHub de um cliente fica assim:
from broker import connect

gh = connect(connection_id)
rules = gh.get("/repos/acme/app/branches/main/protection")
Não existe chave nesse código, no ambiente ou em disco. O stub conhece um endereço e um token.
O broker roda no nosso worker confiável. Ele recebe a chamada, decide se este run pode fazê-la e, se puder, carrega a conexão salva do cliente, descriptografa, assina a requisição e devolve apenas a resposta.
O gateway de credenciais fica um passo mais atrás e guarda os segredos de longa duração, como refresh tokens de OAuth. O broker pede a ele um access token de curta duração e nunca vê o refresh token. O refresh acontece sob um lease no Postgres, um escritor por vez. Parece um detalhe pequeno até você encontrar um provedor com refresh tokens de uso único, em que dois workers fazendo refresh ao mesmo tempo quebram a conexão em silêncio.
Cada zona responde de um jeito diferente à pergunta “o que isso poderia vazar?”. O sandbox poderia vazar uma capability que expira junto com o run. O broker poderia vazar access tokens das conexões que está atendendo naquele momento. Só o gateway guarda segredos que duram, e nada que executa código escrito pelo modelo chega perto dele.
O que acontece em cada chamada
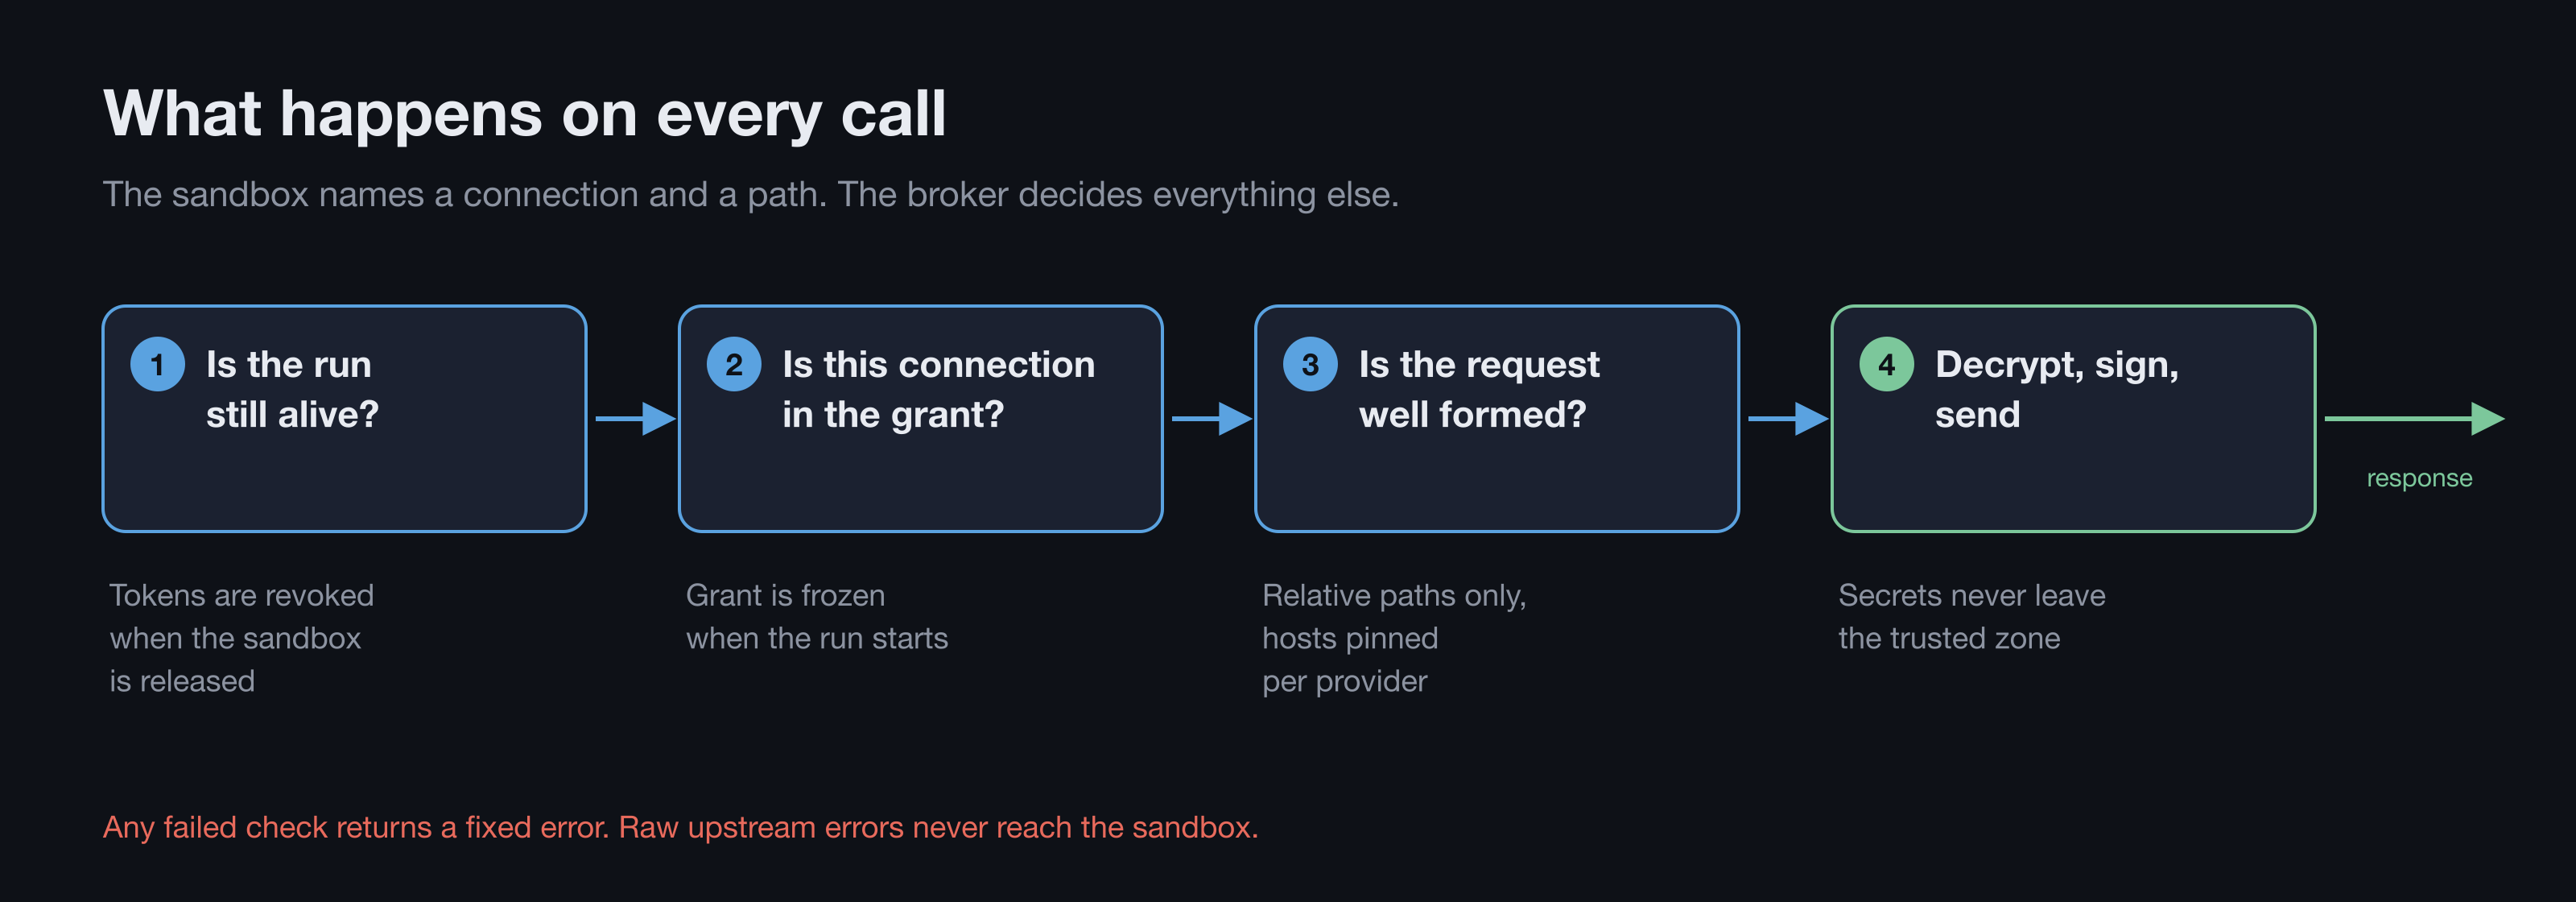
Um diagrama como o de cima é fácil de desenhar e fácil de errar nos detalhes. Quatro decisões carregam a maior parte do peso.
A autoridade fica presa a uma conexão, não a um destino. Muitos proxies de egress anexam credenciais de acordo com o destino do tráfego, o que na prática deixa o agente escolher uma credencial ao escolher um host. No nosso design, o agente informa uma conexão, e o broker decide se este run pode usá-la. Para AWS e GCP, o agente informa só o nome do serviço, validado contra um padrão rígido, e o broker monta o host e assina a requisição do lado dele.
O grant é congelado no início do run. Nesse momento o broker tira um snapshot das conexões que este agente pode usar, e toda chamada é verificada contra ele. Mudar configurações no meio do run pode restringir runs futuros, mas nunca amplia o atual. A lista que o agente recebe é uma conveniência; o snapshot é o que de fato vale.
As capabilities morrem com o run. O token é revogado quando o sandbox é liberado. Os clientes autenticados ficam em cache por run, e não globalmente, então a revogação descarta esses clientes também.
A fronteira é física, além de lógica. Regras de rede dão ao sandbox exatamente um caminho até a zona confiável, terminando em um terminador no host. A identidade de mutual TLS que o broker exige mora ali, fora de qualquer container, então um sandbox que encontre a porta do broker diretamente ainda não consegue completar o handshake. E quando algo falha, o sandbox recebe um erro fixo em vez da mensagem bruta do upstream, porque mensagens de erro de bibliotecas de autenticação costumam conter exatamente o que você estava tentando proteger.
Onde a fronteira termina
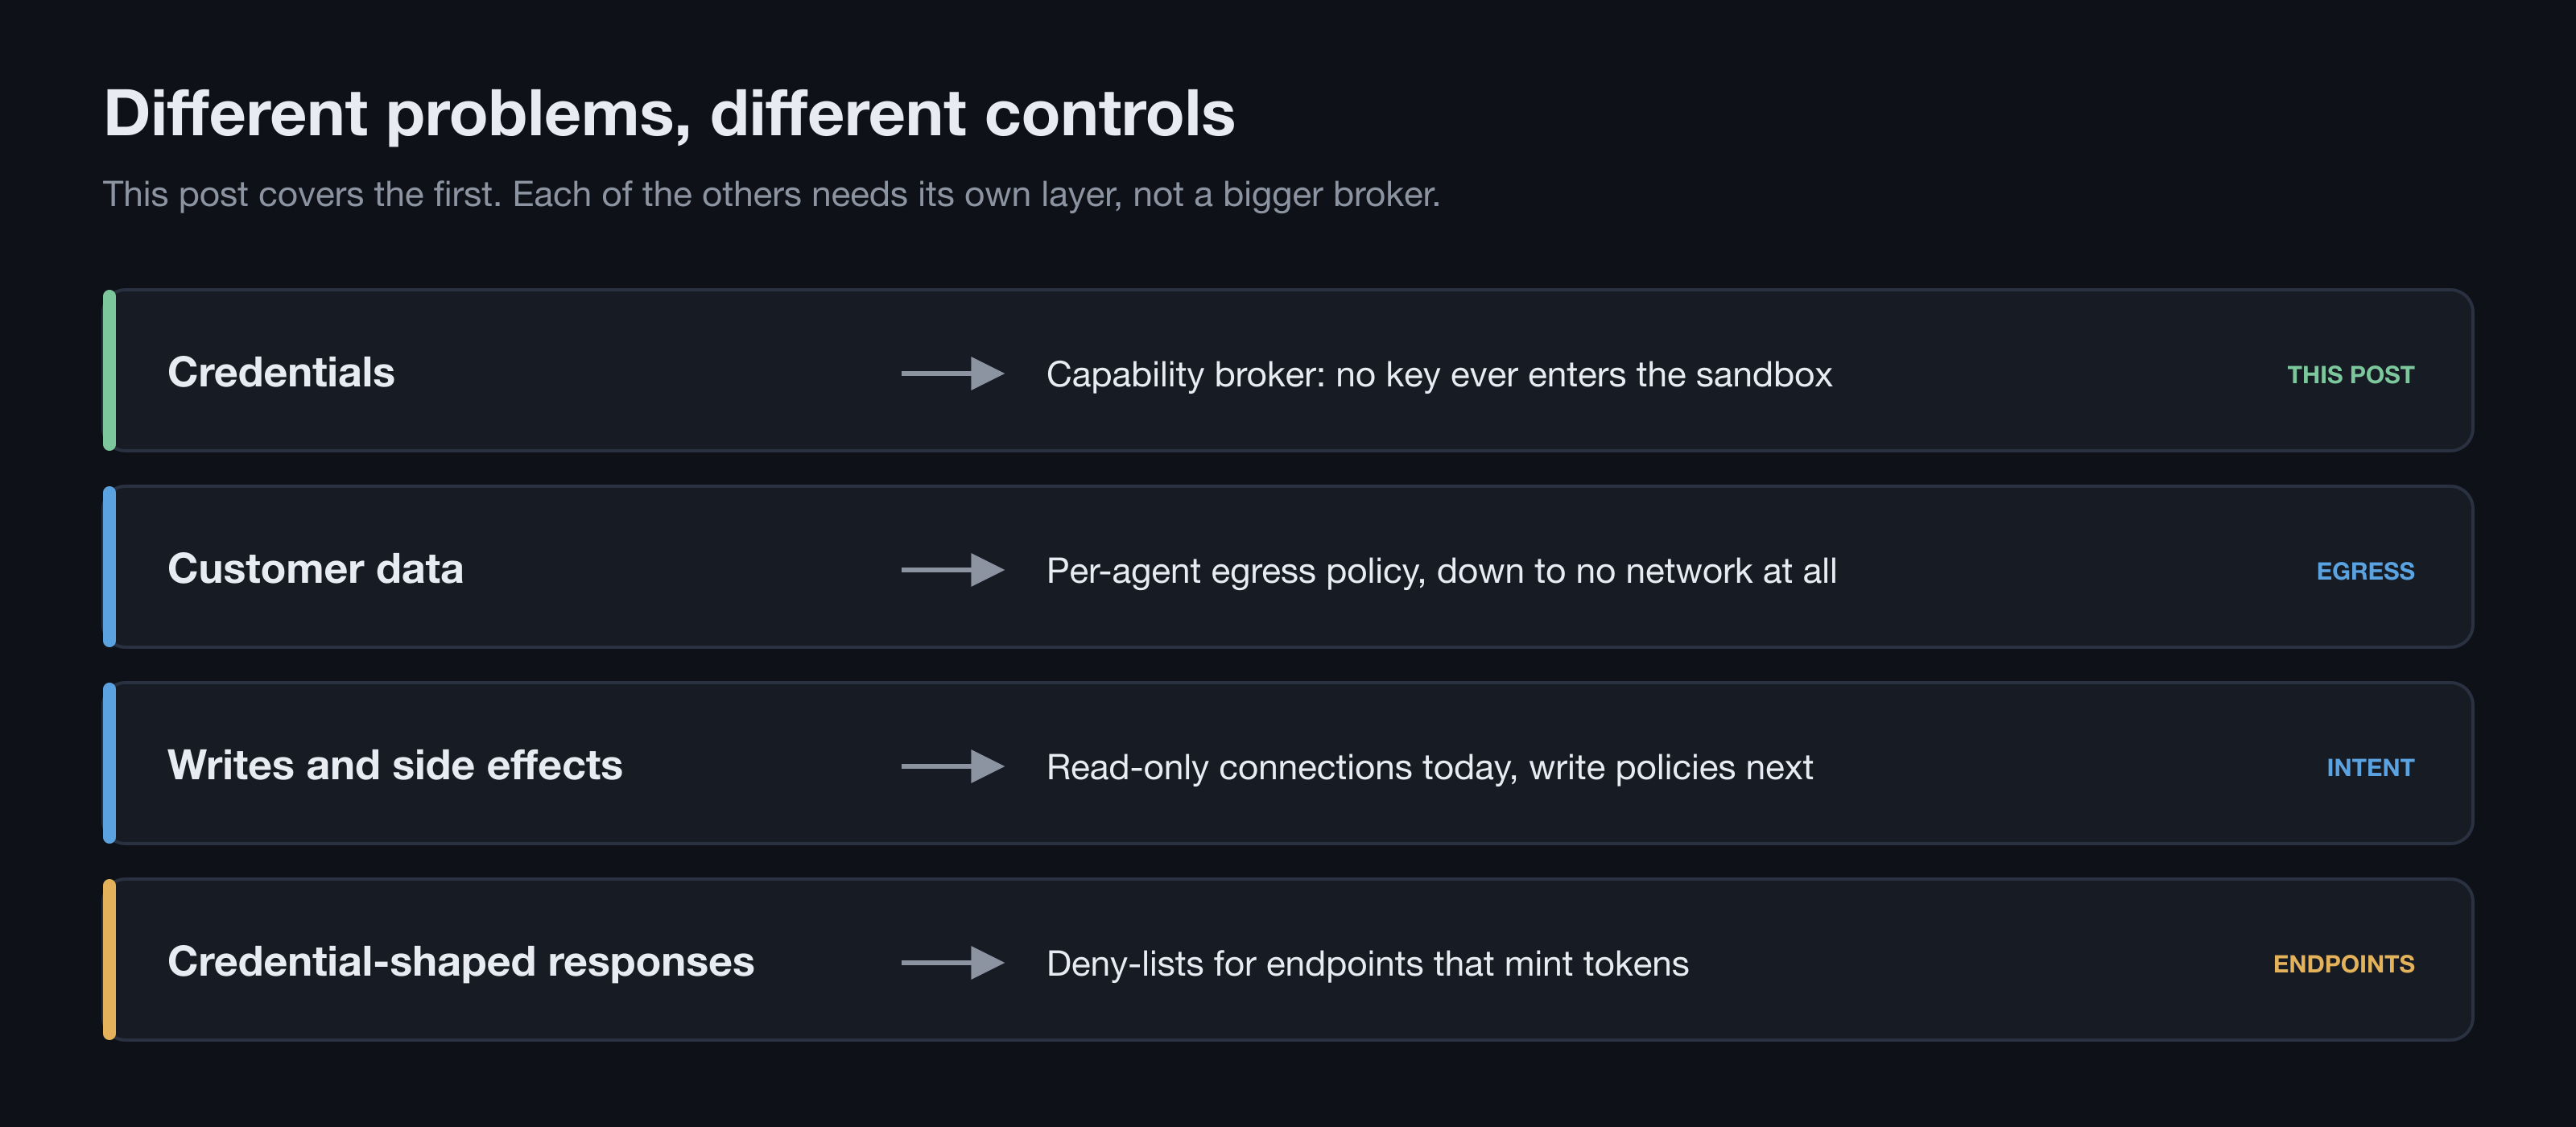
Uma fronteira é mais fácil de confiar quando deixa claro o seu escopo. Esta foi construída para credenciais, e é estreita de propósito. Dados do cliente e efeitos colaterais são problemas diferentes, e na nossa experiência cada um é mais bem atendido por um controle próprio do que esticando o broker para cobrir tudo.
Dados são uma questão de egress. Tudo o que o broker devolve chega ao sandbox, então o que o sandbox pode mandar para fora é decidido separadamente, por agente, e o nosso runtime consegue rodar um agente sem nenhuma rede de saída. Escritas são uma questão de intenção. Coletar evidências é um trabalho de leitura, então recomendamos conexões somente leitura e restringimos os agentes à leitura, e políticas explícitas de escrita são a próxima camada, à medida que os agentes passam de observar sistemas para corrigi-los.
O ponto mais sutil é que um broker de credenciais herda todos os endpoints que suas credenciais alcançam, inclusive aqueles cuja resposta já é uma credencial. A maioria das APIs grandes tem esse tipo de endpoint: troca de tokens, assunção de roles, cofres de segredos, rotas que autenticam como a própria integração em vez de como o cliente. O cliente HTTP dentro do broker também faz parte da superfície de ataque. Conveniências de SDK, como objetos de opções que podem sobrescrever a URL de destino, ou hooks de autenticação que trocam de identidade dependendo da rota, são inofensivas quando o seu código as chama e arriscadas quando os argumentos vêm de um agente. Se você for construir algo assim, faça duas perguntas cedo. O agente consegue ver o token? E existe alguma requisição cuja resposta seja um token? Bloqueie as rotas que emitem credenciais, e nunca passe input do agente direto para a configuração do cliente.
Princípios
Tirando nossas especificidades, é isto que eu levaria para qualquer sistema em que agentes chamam APIs reais em nome de outra pessoa:
- Assuma que o agente é o atacante. Os modelos não são maliciosos, mas leem conteúdo escrito por pessoas que podem ser.
- Entregue capabilities, não credenciais. O que entra no sandbox deve ser inútil fora do run que o criou.
- Prenda a autoridade a conexões, não a destinos.
- Congele os grants quando o run começa. Mudanças podem restringir o acesso durante um run, nunca ampliar.
- Mantenha os segredos de longa duração a dois passos do código escrito pelo modelo.
- Trate endpoints e bibliotecas cliente como parte da fronteira.
- Seja explícito sobre o escopo. Credenciais, dados e efeitos colaterais são problemas diferentes, e cada um merece um controle próprio.
Perguntas em aberto
Alguns problemas ainda me parecem em aberto.
O egress de dados é o mais óbvio. Tirar o acesso à rede dos runs que só precisam de APIs intermediadas pelo broker fecha a tríade por completo, mas parte do trabalho legítimo precisa da internet aberta. Políticas de egress por agente são o meio-termo provável, e a parte difícil é mantê-las precisas sem que virem um fardo de manutenção.
Escritas vêm logo depois. Coletar evidências é quase só leitura, enquanto a próxima geração de agentes de compliance vai remediar: abrir o pull request, rotacionar a chave, fechar o ticket. Um modelo de capabilities para escritas precisa de intenção declarada, aprovação humana para o subconjunto arriscado e uma trilha de auditoria que o time de segurança do cliente aceite.
Por fim, proveniência. Hoje o registro do que um agente fez vive no log do run. O que os times de segurança pedem cada vez mais é um registro independente na própria fronteira, mostrando qual run, qual conexão, qual endpoint e o que voltou. Imagino que isso vire requisito padrão para agentes que tocam sistemas de produção.
Eu sempre volto à mesma conclusão neste blog: o modelo não é a fronteira de segurança, o sistema ao redor dele é. A coisa mais útil que uma plataforma de agentes pode fazer é tornar impossível, e não apenas improvável, a versão perigosa de um erro. Uma capability no lugar de uma credencial é uma forma pequena e concreta de fazer isso, e eu adoraria trocar ideias com quem está traçando a mesma linha.
Me encontre no LinkedIn ou em hello@hugo.im.